
Topics
Тема
Центр объединения данных. Внутри данные делятся по сообщениям. Сообщение:
- значение (value) - данные, обязательное
- (partition number)
- ключ (key) -
Создание темы (topic)
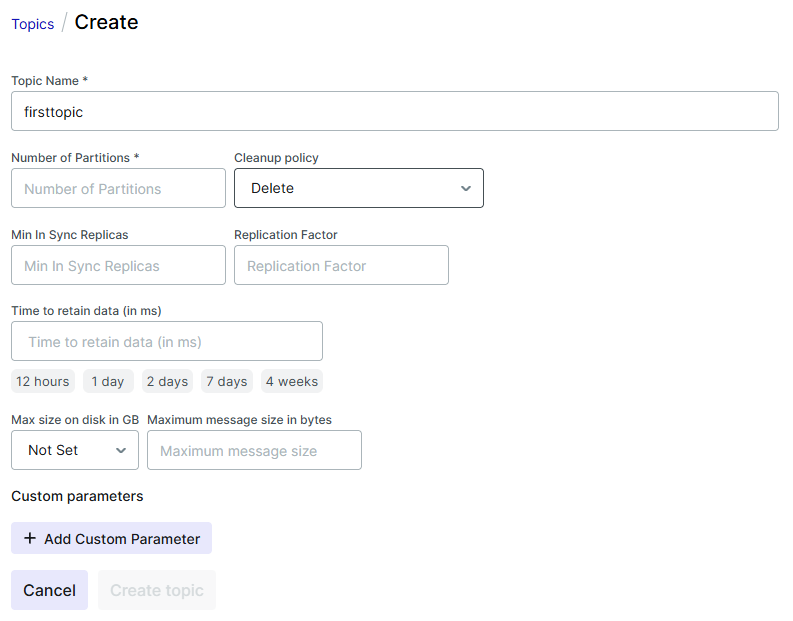
| Поле | Тип данных | Описание | ||||||||||
| Topic Name | Строка | Название темы. | ||||||||||
| Number of partitions | Целое число |
Количество разделов — управление производительностью и масштабируемостью кластера. Единицы параллелизма в Kafka. Разделы определяют скорость и масштабирование.
Пример: для 10 разделов можно запустить до 10 потребителей, и каждый будет обрабатывать свой раздел. Если потребителей больше, чем разделов, то лишние потребители будут простаивать и тратить ресурсы впустую . Дополнительные факторы
Практические рекомендации
Выбор "Number of partitions" — это всегда компромисс между желаемой производительностью, требованиями к порядку данных и операционными затратами на поддержку кластера. |
||||||||||
| Cleanup policy |
Список.
|
Политика управления сроком жизни данных. По умолчанию delete. Политика delete (Удаление) Удаление старых данных по истечении заданного времени или при превышении лимита размера. Как это работает: удаление когда старше retention.ms (по умолчанию 7 дней), или когда общий размер раздела превышает retention.bytes. Происходит в фоновом режиме с заданным интервалом. Когда применять: потоки событий и логов, где важна вся история. Например, логи приложений, метрики, трекинговые события. Здесь каждое сообщение самоценно, и старые данные со временем теряют актуальность . Политика compact (Сжатие) Эта политика работает по принципу "сохранить только последнее известное состояние" для каждого ключа сообщения . Как это работает: В фоновом режиме для каждого уникального ключа (key) в разделе остается только последнее по времени сообщение, а все промежуточные удаляет. Сообщения обязаны иметь ключ (key), без ключа будут удалены при сжатии. Когда применять: для хранения состояние или конфигурации. Например:
Комбинированная политика delete,compact Как это работает: сначала удаляются старые данные по времени/размеру, а затем сжимается оставшийся лог. Это полезно, когда нужно ограничить общий объем данных и гарантировать, что для каждого ключа в пределах этого срока хранения сохранится только последнее значение.
Как выбрать? Важна ли полная история событий или только их текущее состояние? Если история — выбирайте delete. Если состояние — выбирайте compact. |
||||||||||
| Min in sync replicas | Целое число |
Минимальное количество брокеров-подписчиков, которые должны подтвердить запись, чтобы она считалась успешной. Иначе — это порог, защищающий от потери данных при сбое брокеров. Работает в паре с настройкой продюсера acks (подтверждения). У топика replication.factor = 3 (3 копии данных на разных брокерах), а min.insync.replicas = 2.
Ключевой момент: если в кластере внезапно упадут 2 брокера из 3, и в живых останется только 1 (лидер), то условие min.insync.replicas=2 перестанет выполняться. В этом случае брокер откажется принимать новые сообщения и вернет продюсеру ошибку NotEnoughReplicasException. Компромисс: Надежность vs Доступность Это выбор между Consistency (согласованностью) и Availability (доступностью) из теоремы CAP. Высокое значение (например, 2 или 3): ✅ Плюс: Максимальная надежность. Вы гарантированно не потеряете данные, даже если несколько брокеров выйдут из строя. ❌ Минус: Риск недоступности. Если выйдет из строя больше брокеров, чем min.insync.replicas, топик станет read-only, пока не починят брокеры или не уменьшите параметр. Низкое значение (например, 1): ✅ Плюс: Максимальная доступность. Топик всегда будет принимать данные, даже если у вас работает всего 1 брокер из 3. ❌ Минус: Риск потери данных. Если лидер упадет в момент, когда он единственный хранил новое сообщение (остальные реплики еще не получили его), это сообщение будет потеряно безвозвратно. Правило настройки (Золотое правило) При настройке топика нужно строго соблюдать соотношение: min.insync.replicas ≤ replication.factor И, что важнее, для реальной отказоустойчивости min.insync.replicas должно быть ≤ (replication.factor - 1). |
||||||||||
| Replication factor | Целое число |
Фундамент отказоустойчивости. Определяет, сколько всего копий каждого раздела будет храниться в кластере Kafka. Есть топик с replication.factor = 3. Это значит, что каждый раздел этого топика будет физически скопирован на 3 разных брокера. Для каждого раздела Kafka выбирает:
Репликация происходит на уровне разделов, а не топиков целиком. Если в топике 10 разделов и replication.factor=3, то в кластере будет храниться 30 копий этих разделов (10 разделов × 3 реплики).
Что происходит при сбое:
На что влияет replication.factor
Правила настройки
RF=1 — любая потеря брокера = потеря данных. Только для dev/test. RF=2 — переживает падение 1 брокера. Но при обслуживании кластера (rolling restart) вы остаетесь без запаса. RF=3 — стандарт индустрии. Переживает падение 2 брокеров, позволяет обслуживать кластер без простоя.
Если у вас 3 брокера, вы не можете поставить RF=5 — Kafka не сможет разместить все реплики. Максимум = число брокеров.
Классическая production-конфигурация: replication.factor = 3 Это дает: данные записаны минимум на 2 брокера, и кластер переживает падение 1 брокера без потери доступности на запись.
|
||||||||||
| Time to retain data | Целое число, ms |
определяет время хранения сообщения в топике перед удалением. По умолчанию 7 дней (168 часов). Есть два уровня настройки: на уровне брокера и на уровне конкретного топика.
Удаление происходит по сегментам, а не по сообщениям Kafka не удаляет отдельные сообщения. Лог раздела разбит на сегменты (segments). Параметр retention.ms определяет, когда закрытый (неактивный) сегмент становится кандидатом на удаление. Что это значит на практике: Активный сегмент (тот, в который сейчас пишутся данные) никогда не удаляется, даже если его сообщения «просрочены». Проверка на удаление запускается периодически (по умолчанию каждые 5 минут), а не мгновенно. Дополнительная задержка в 1 минуту (file.delete.delay.ms) перед физическим удалением файла. Пример из практики (низкая нагрузка) Вы хотите хранить данные 1 день, но у вас мало сообщений. Активный сегмент не «закрывается» (не достигает лимита по размеру segment.bytes или времени segment.ms), поэтому он живет долго. Результат: сообщения могут храниться до 2 дней (1 активный сегмент + 1 неактивный), хотя вы задали retention.ms=1 день. Kafka позволяет комбинировать два независимых ограничения:
Практические рекомендации |
||||||||||
| Maximum message size in bytes | Целое число, bytes | Потолок одного пакета. Но пакеты могут объединяться, так что потолок может быть превышен. | ||||||||||
| Custom parameters | Разные | Дополнительные параметры для тонкой настройки. |